H100到底是什么卡,为什么AI圈都在提它

[复制链接]
发表于 18 小时前 来自手机 | 显示全部楼层 |阅读模式
经常看AI新闻的朋友应该对H100这个名字不陌生,动不动就是几万张H100、H100集群之类的说法。很多人第一反应是这卡比5090还强吗,多少钱能买一张。这里就把它讲清楚,H100和咱们桌面上插的显卡完全是两个世界的产品。

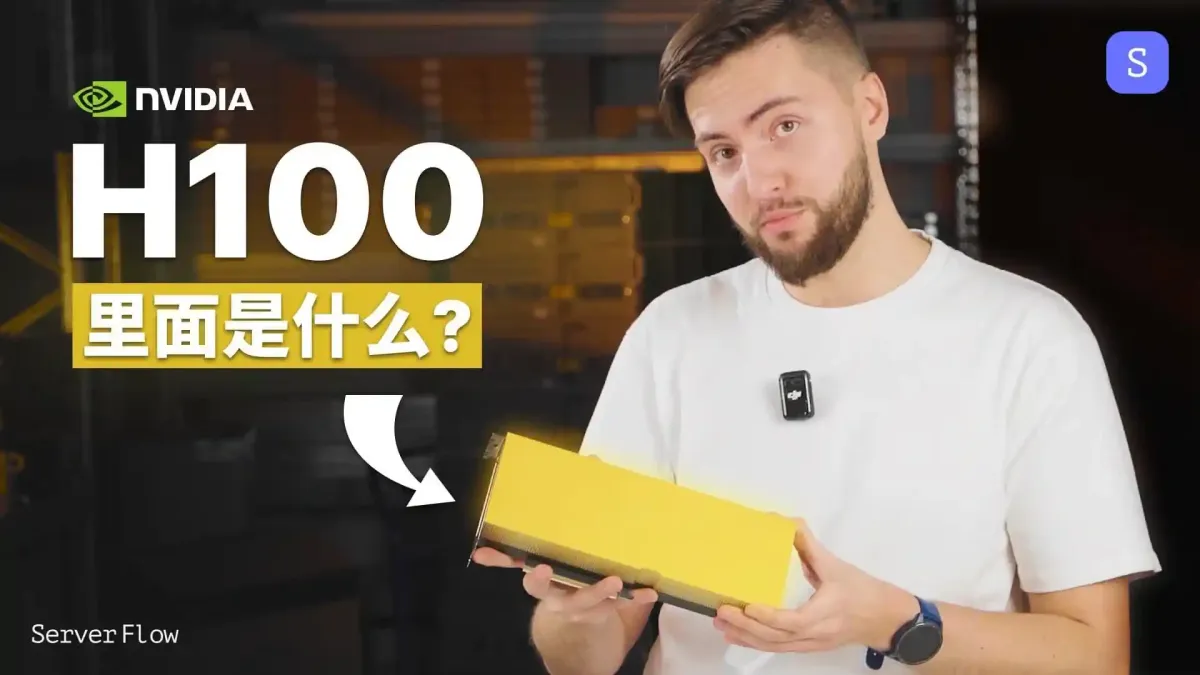
先明确定位。H100是英伟达在2022年发布的数据中心AI加速卡,属于第九代数据中心GPU,接替上一代的A100。它不是用来打游戏的,没有视频输出接口的考虑,也不针对个人用户,卖的都是云厂商、AI公司和各大实验室,用来训练和运行大模型。这两年叫得上名字的大模型,训练集群里几乎都有它的身影,可以说它就是这轮AI浪潮里最具代表性的算力底座。

参数上看确实堆料很猛。H100基于Hopper架构,集成800亿个晶体管,采用台积电4N定制工艺,搭载80GB的HBM3显存,带宽达到3.35TB每秒,是全球首款用上HBM3和PCIe 5.0的GPU。它最核心的升级是第四代Tensor Core引入了FP8精度和Transformer引擎,官方宣称训练大模型的速度比A100最高快数倍,推理场景提升更明显。用单张卡是跑不动几百亿上千亿参数模型的,实际部署都是成百上千张H100组成集群,通过900GB每秒的NVLink互连,配合高速网络做多机多卡协同,一套8卡的H100服务器整机价格要20万美元级别,单卡海外参考价就在2.5万到4万美元之间。

围绕H100还有几个衍生型号容易搞混,顺便梳理一下。H200可以理解为显存加强版,计算核心和H100一样,显存翻到141GB的HBM3e,带宽提升到4.8TB每秒,更适合长上下文推理和大参数模型。H800是针对中国市场的合规版本,算力规格与H100一致,但卡间互连带宽被砍到400GB每秒,影响多卡组网的效率。还有H20,限制更严,FP8算力只有H100的15%左右,不过保留了96GB显存和不错的带宽,主要用在推理场景。这几张卡的区别本质上都来自出口管制政策,算力和互连规格被一步步限制出来的。

这里要提醒一句,H100和H200都属于美国出口管制范围,正规渠道在国内是不直接销售的。市面上能见到的水货不仅价格被炒得很高,还存在没有保修、可能被远程锁卡、来源不合规等一堆问题,个人和普通企业基本碰不到也用不上。国内合规可买的主要是H20这类特供型号,以及L20、L40S等面向推理的产品。另外H100的继任者也已经登场了,Blackwell架构的B200在AI性能上又是一个量级的提升,数据中心这块的迭代速度和它的价格一样夸张。

简单总结,H100就是AI大模型时代最出名的一块天价计算卡,是给云厂商和AI公司买去组集群的算力底座,和玩家手里的RTX 5090压根不在一个赛道。普通人了解它,主要就是看懂AI新闻里的算力叙事到底指的是什么。

scaled_1000160709.webp
万狸温馨提示:理性消费
1.数码选品:先定用途,再比参数,拒绝 “加点钱更好” 的超支诱惑。
2.购车决策:看平台生命周期,算长期使用成本,刚需比潮流更重要。
3.重点提醒:多查真实评价,少信首发噱头,买得对远比买得新划算。
4.交流准则:聊产品讲实际体验,不抬杠不诋毁品牌,友善分享。
5.氛围维护:遇到分歧先理性沟通,不贴“粉黑”标签,温馨交流。
您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

关注QQ群
手机版|小黑屋|万狸社区-免费活跃数码论坛,手机/电脑/汽车+旅游美食游戏兴趣社区

相关侵权、举报、投诉及建议等,请发 E-mail:572109352@qq.com

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.|桂ICP备16003785号
在本版发帖
客服QQ:572109352
QQ客服返回顶部