英特尔发布D270 AI推理卡:单卡480GB内存,专攻代理式AI

[复制链接]
发表于 6 小时前 来自手机 | 显示全部楼层 |阅读模式
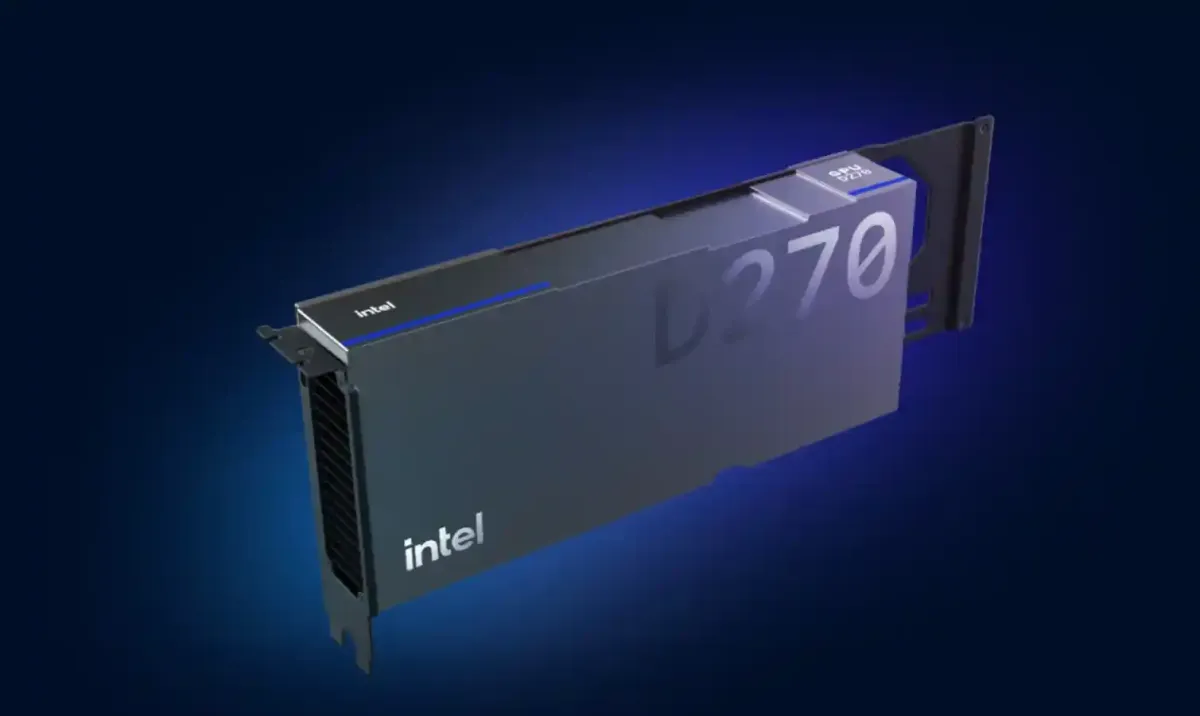
在近日举行的OCP全球峰会上,英特尔正式发布了面向数据中心的GPU D系列加速卡,首款旗舰型号为D270。这款产品基于英特尔最新的Xe3P架构,专为AI推理工作负载设计,定位非常明确:不做训练,只做推理。

超大内存是最大亮点

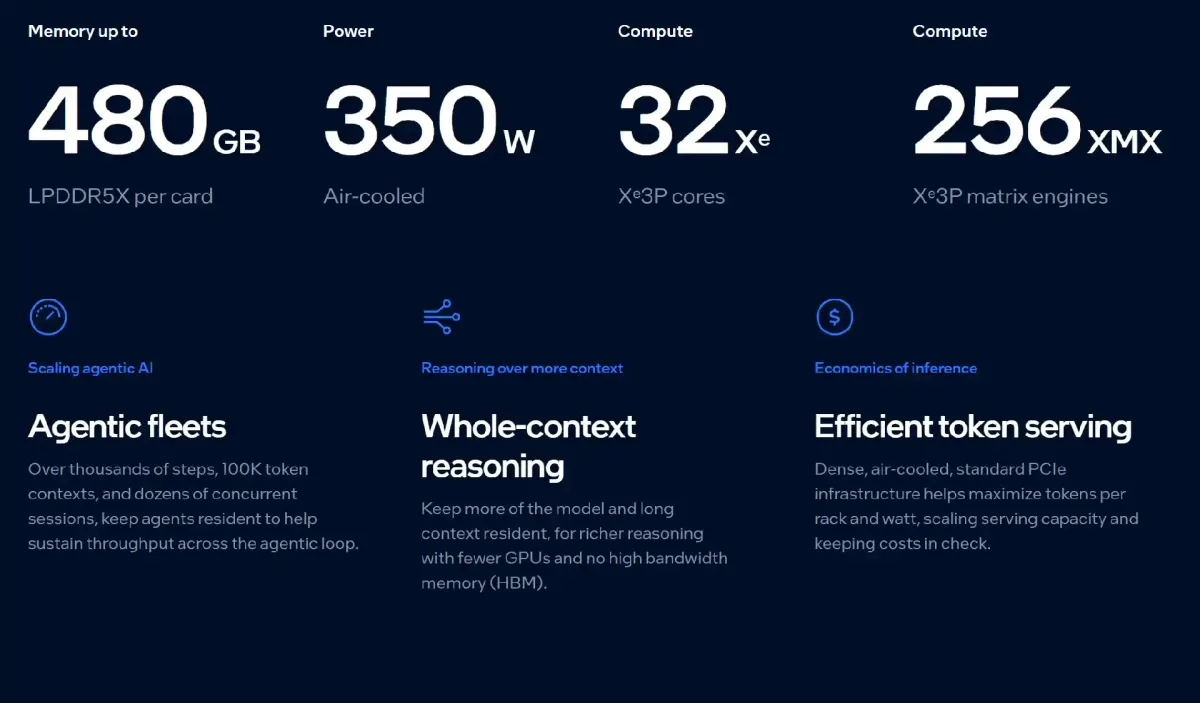
D270最引人注目的特征是其内存配置。它采用LPDDR5X内存取代了传统加速卡上常见的HBM。英特尔自有品牌显卡出厂配备160GB,而ODM合作伙伴最高可定制到480GB。旗舰型号的内存带宽达到1.5TB/s,由20颗内存芯片、80通道的总线提供支持。如此大的内存容量意味着,单张D270就能承载约3000亿参数规模的大模型,八卡集群则可运行超过万亿参数的模型。

能效与部署优势

D270的整卡功耗控制在350W,采用标准的PCIe 5.0插卡形态和无源风冷设计。这意味着它可以装进现有的标准服务器,无需为了部署而进行液冷改造,直接降低了数据中心的硬件升级门槛。在算力方面,其FP8矩阵峰值达到1.3 PFLOPS。虽然峰值算力并非同类产品中最高的,但350W风冷的设计使其在能效和成本上具备了独特的竞争力。

为什么用LPDDR5X取代HBM?

在加速卡上使用LPDDR5X而非HBM,是D270一个反直觉但颇具针对性的选择。LPDDR5X的单位容量成本更低、功耗更小,供应链也更宽泛,代价是峰值带宽不及HBM。但英特尔通过增加并行度来弥补这一差距。对于代理式AI而言,一个任务往往要运行上千步,上下文动辄十万token,瓶颈通常不在于算得多快,而在于模型和上下文能否常驻在显存里。D270的设计思路正是让模型留在卡上,减少反复搬运带来的开销。

软件生态与兼容性

软件层面,D270沿用统一的Xe软件栈,支持vLLM与PyTorch等主流框架,并兼容SGLang、llm-d等生态。基于Arc Pro显卡开发的代码无需重写内核即可移植到D系列,同时该卡还实现了对Meta Muse Glimmer 300亿参数开放权重模型的零日支持。

市场定位与影响

这是英特尔自2021年Ponte Vecchio之后的首款商用数据中心GPU,期间Rialto Bridge于2023年、Falcon Shores于2025年先后取消。D270选择了一条差异化的路线:在推理和代理式AI成为主战场的当下,决定成本的已不只是算力峰值,而是同样的功耗和机柜空间里能同时装下多少模型与上下文。目前英特尔已向服务器OEM、ODM厂商及云服务商提供样品,价格和量产时间尚未公布。

总体来看,D270是英特尔在AI推理加速市场投下的一枚重要棋子,其大内存、低功耗、风冷部署的组合,为需要运行大模型推理的企业提供了一种注重实用成本的选择。

scaled_1000158108.webp
scaled_1000158109.webp
万狸温馨提示:理性消费
1.数码选品:先定用途,再比参数,拒绝 “加点钱更好” 的超支诱惑。
2.购车决策:看平台生命周期,算长期使用成本,刚需比潮流更重要。
3.重点提醒:多查真实评价,少信首发噱头,买得对远比买得新划算。
4.交流准则:聊产品讲实际体验,不抬杠不诋毁品牌,友善分享。
5.氛围维护:遇到分歧先理性沟通,不贴“粉黑”标签,温馨交流。
您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

关注QQ群
手机版|小黑屋|万狸社区-免费活跃数码论坛,手机/电脑/汽车+旅游美食游戏兴趣社区

相关侵权、举报、投诉及建议等,请发 E-mail:572109352@qq.com

Powered by Discuz! X5.0 © 2001-2026 Discuz! Team.|桂ICP备16003785号
在本版发帖
客服QQ:572109352
QQ客服返回顶部